Ba bài toán sau khi tắt trợ lý mới là chỗ cần đọc
Trước khi chuyển tiếp câu “10 phút dùng AI là mất kiên trì”, mở thí nghiệm thứ hai và ghi tỷ lệ làm đúng cùng tỷ lệ bỏ qua.
Xong bài này bạn làm được Ghi lại tỷ lệ làm đúng và tỷ lệ bỏ qua của thí nghiệm thứ hai, rồi chỉ siết việc xin đáp án thẳng nếu đó đúng cách mình đang dùng, thay vì cấm mọi lần mở trợ lý.
Trong nhóm ôn thi có một tin được chuyển tiếp: “Berkeley vừa chứng minh chỉ 10 phút dùng AI là mất khả năng kiên trì. Tuần này cấm mở trợ lý khi làm bài tập.” Người gửi không kèm bài báo. Việc làm trước khi trả lời là mở đúng bài nghiên cứu và ghi ba dòng về thí nghiệm mà các tác giả coi là sạch hơn, không phải đổi luật học của cả tuần.
Tin đó trỏ tới bài trên Berkeley News ngày 9/10/2026. Trang tin nói một nhóm nghiên cứu thấy rằng khoảng 10 phút dựa vào công cụ AI làm giảm khả năng tập trung và kiên trì với việc khó. Trang cũng nói có 1.222 người tham gia các thử nghiệm ngẫu nhiên, thí nghiệm đầu có 354 người làm phân số, thí nghiệm lớn hơn có 667 người, và thí nghiệm đọc hiểu có 201 người. Đó là cách trang tin kể. Bài báo gốc, đăng trên arXiv với mã 2604.04721, kể thí nghiệm thứ hai chặt hơn trang tin.
Ba số của thí nghiệm thứ hai
Thí nghiệm 2 tuyển 667 người đang ở Mỹ qua Prolific, một nền tảng trả tiền cho người làm khảo sát trực tuyến. Mỗi người được 3,40 đô la Mỹ. Các tác giả ước lượng buổi làm khoảng 15 phút. Đây là thù lao cho người tham gia ở Mỹ, không phải giá một phần mềm tại Việt Nam.
Mọi người làm phân số. Trước hết là ba câu một bước, không có trợ lý. Sau đó một nhóm được thanh bên có GPT-5, mô hình của OpenAI đã được đưa sẵn đề bài và lời giải, nên gõ xin đáp án là nhận được lời giải. Nhóm kia không có trợ lý đó. Rồi trợ lý bị tắt và cả hai nhóm làm ba câu cuối giống nhau. Người tham gia có thể bấm bỏ qua câu. Vì họ được nói rằng trả lời sai không bị phạt tiền, các tác giả dùng nút bỏ qua như dấu hiệu của việc không tiếp tục, tách khỏi việc giải đúng hay sai.
Sau khi loại người không qua câu kiểm tra chú ý và người không làm đúng ít nhất một trong ba câu dễ lúc đầu, còn 585 người: 308 từng có trợ lý và 277 không có. Tỷ lệ bị loại gần nhau, 11,7% và 12,9%. Các tác giả viết điều này để xử lý một lỗi của thí nghiệm 1: ở thí nghiệm đầu, cách loại người có thể giữ lại trong nhóm có trợ lý những người vốn không làm được phân số cơ bản nhưng đã nộp đáp án do máy đưa.
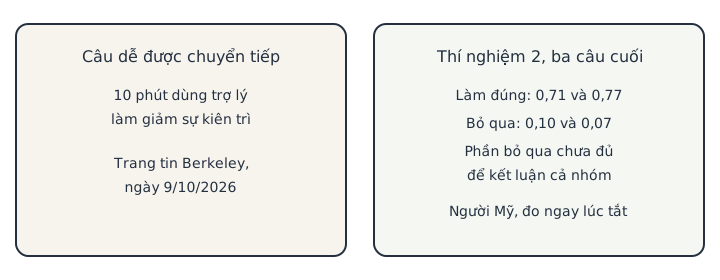
Ở ba câu cuối của thí nghiệm 2, nhóm từng có trợ lý làm đúng trung bình 0,71, nhóm chưa dùng làm đúng trung bình 0,77. Các tác giả báo cáo khác biệt này vượt ngưỡng họ dùng để gọi là có ý nghĩa thống kê (p = 0,020). Tỷ lệ bỏ qua câu là 0,10 so với 0,07. Với con số bỏ qua của cả nhóm, các tác giả viết khác biệt chưa đạt ngưỡng đó (p = 0,239).
Trang Berkeley News mô tả nhóm lớn này là làm sai hoặc bỏ cuộc hẳn khi bị rút trợ lý, còn nhóm không dùng trợ lý kiên trì và thành công hơn ở cuối. Câu đó là lời kể của trang tin. Trong bài báo, phần “bỏ cuộc” của cả nhóm ở thí nghiệm 2 chưa đủ để kết luận. Phần “làm đúng kém hơn ngay sau khi tắt” thì các tác giả giữ lại.
Thí nghiệm 1, với mẫu còn 307 người sau khi loại, cho tỷ lệ làm đúng 0,57 so với 0,73 và tỷ lệ bỏ qua 0,20 so với 0,11. Các tác giả chính là người gắn cảnh báo về cách loại mẫu ở thí nghiệm đó. Con số 354 trên trang tin là số người được tuyển lúc đầu, trước lần loại mẫu mà các tác giả sau đó coi là chưa sạch.
Xin đáp án khác với xin một bước
Cuối thí nghiệm 2, nhóm có trợ lý tự khai cách dùng. 189 người, tức 61%, nói họ chủ yếu xin đáp án. 82 người, 27%, nói họ xin gợi ý hoặc lời giải thích. 37 người, 12%, nói họ không dùng. Các tác giả đối chiếu lời khai với nhật ký chat cho nhóm nói rằng mình không dùng: phần lớn nhóm đó gần như không nhắn.
Ở ba câu cuối, nhóm tự khai là xin đáp án làm đúng trung bình 0,65, so với 0,77 của nhóm không có trợ lý. Tỷ lệ bỏ qua của nhóm xin đáp án là 0,13 so với 0,07, và các tác giả báo cáo khác biệt này vượt ngưỡng (p = 0,033). Nhóm xin gợi ý làm đúng trung bình 0,76, gần nhóm không có trợ lý.
Các tác giả nói thẳng phân tích này là cắt ngang trên những người đã ở trong nhóm có trợ lý. Nó cho thấy chỗ chênh lệch nằm ở đâu. Nó không chứng minh rằng chính hành động xin đáp án gây ra việc bỏ qua, vì người ta tự chọn cách dùng chứ không bị gán ngẫu nhiên vào “chỉ được xin đáp án” hay “chỉ được xin gợi ý”.
Thí nghiệm 3 đổi sang đọc hiểu, lấy câu từ tài liệu luyện SAT miễn phí trên mạng. SAT là kỳ thi chuẩn hóa dùng trong tuyển sinh đại học ở Mỹ. Đây không phải đề thi thật. Mẫu còn 168 người. Nhóm từng có trợ lý làm đúng trung bình 0,76 so với 0,89, và bỏ qua 0,08 so với 0,01. Ở thí nghiệm này các tác giả báo cáo cả hai khác biệt đều vượt ngưỡng. Một câu trả lời dưới năm giây cũng bị tính là bỏ qua, vì không kịp đọc đoạn văn. Vậy “dễ bỏ hơn” xuất hiện rõ ở bài đọc này, và không xuất hiện đủ rõ khi gộp cả nhóm phân số của thí nghiệm 2.
Bài báo còn một câu giới hạn ở phần mở: các tác giả khuyên không nên đọc kết quả như bằng chứng rộng rằng trợ lý AI làm giảm sự kiên trì và năng lực tự làm ở mọi việc. Phần tóm tắt cho công chúng nói nếu hiệu ứng cộng dồn qua nhiều ngày thì đáng lo. Đó là điều họ chưa đo. Buổi thí nghiệm dừng ngay sau khi tắt trợ lý.
Câu trả lời gửi lại nhóm
Tin trong nhóm là ví dụ giả lập, dựng để thấy một câu chuyển tiếp. Không có nhóm ôn thi nào đã gửi đúng đoạn đó trong bài này.
Ba dòng đủ để trả lời:
Bạn ghi: thí nghiệm sạch hơn đo ngay lúc tắt trợ lý, trên người lớn ở Mỹ làm phân số lấy từ phòng thí nghiệm, không đo một tuần học của lớp mình. Cả nhóm từng có trợ lý làm đúng kém hơn ở ba câu cuối, 0,71 so với 0,77. Phần bấm bỏ qua của cả nhóm, 0,10 so với 0,07, các tác giả chưa gọi là khác biệt đủ để kết luận. Chỗ bỏ qua cao hơn nằm ở nhóm tự khai là xin đáp án, và bài báo không coi đó là bằng chứng nhân quả.
Việc đổi trong tuần này, nếu bạn đang học theo kiểu đó: lần làm bài tới, xin một bước rồi tự viết câu tiếp theo khi thanh trợ lý đã đóng. Câu trên trang tin chưa đủ để thành lệnh cấm mọi lần mở trợ lý trong 10 phút. Trang tin và bài báo không đo lịch học của bạn.
Nếu tin nhắn nói “đã chứng minh học sinh Việt Nam mất kiên trì”, câu đó không có trong hai nguồn này. Mẫu là người tham gia ở Mỹ.
Nguồn tham khảo
- Liu, Christian và cộng sự — AI Assistance Reduces Persistence and Hurts Independent Performance, arXiv:2604.04721 — thiết kế ba thí nghiệm, mẫu sau khi loại, tỷ lệ làm đúng và bỏ qua ở thí nghiệm 2 và 3, tỷ lệ tự khai xin đáp án, và câu giới hạn rằng kết quả không phải bằng chứng cho mọi việc.
- Berkeley News, 9/10/2026 — Using AI for just 10 minutes erodes your ability to persist at hard things — bài tin của trường, với câu 10 phút, tổng 1.222 người, và cách kể thí nghiệm 354, 667 rồi 201 người.
Tiếp trên bàn Kiểm tra trước khi tin: Hỏi trường 12 tiết AI nằm ở đâu trước khi mua tài khoản